GLPI ticketing : configuration et bonnes pratiques

GLPI reste une référence solide pour structurer un service de ticketing sans faire exploser les coûts. Encore faut-il éviter le piège classique : installer l’outil, créer quelques catégories, puis espérer que la gestion des tickets s’organise d’elle-même. Dans les PME, ce scénario produit souvent l’inverse de l’effet recherché : files d’attente confuses, demandes mal affectées, urgences mal évaluées et équipes support qui passent plus de temps à trier qu’à résoudre.
La vraie valeur de GLPI ticketing apparaît quand la configuration sert un objectif métier clair : réduire les délais, mieux répartir la charge et rendre le support informatique plus lisible pour les utilisateurs comme pour la direction. Il ne s’agit pas seulement d’ouvrir des tickets, mais de bâtir un workflow cohérent, avec des règles de priorisation, des SLA réalistes, des notifications utiles et des bonnes pratiques applicables au quotidien. C’est précisément ce qui distingue un helpdesk subi d’un dispositif rentable.
En bref
- GLPI fonctionne mieux quand le périmètre de support est défini avant la technique.
- Une bonne configuration commence par les catégories, groupes, profils et règles d’affectation.
- La gestion des tickets gagne en efficacité avec une vraie logique de priorisation.
- Les SLA doivent refléter les contraintes réelles d’une PME, pas un modèle théorique.
- Les notifications sont utiles si elles informent sans saturer les agents.
- Les bonnes pratiques réduisent les retards, les doublons et les escalades inutiles.
- Un suivi simple des indicateurs suffit souvent à améliorer fortement le support informatique.
GLPI ticketing : poser une configuration utile avant de créer des tickets
Le premier levier de performance dans GLPI, ce n’est pas l’automatisation avancée. C’est la clarté du cadre initial. Beaucoup de PME démarrent vite, parce que l’outil est connu, mature et riche. Pourtant, un déploiement précipité entraîne un défaut coûteux : tout le monde peut créer n’importe quelle demande, dans n’importe quelle catégorie, avec une qualité d’information trop faible pour être exploitable. Le résultat est immédiat : les techniciens requalifient manuellement, la file grossit et la perception du service se dégrade.
Prenons le cas d’une PME fictive de 85 salariés, répartis sur deux sites. Avant GLPI, les incidents arrivaient par téléphone, e-mail et messagerie interne. Après installation, l’entreprise a bien centralisé les sollicitations, mais sans structurer les formulaires, les profils ou les groupes. En trois semaines, les tickets “ordinateur lent”, “accès impossible”, “demande logiciel” et “imprimante” se retrouvaient dans un même flux. Le support avait gagné un canal unique, mais perdu en lisibilité. C’est un cas fréquent, et surtout évitable.
Une configuration efficace commence par une question simple : quels types de demandes voulez-vous vraiment traiter dans GLPI ? Selon les PME, le périmètre couvre les incidents utilisateurs, les demandes d’accès, les équipements, les arrivées et départs collaborateurs, voire une partie des services généraux. Tant que ce périmètre n’est pas clair, la structure du ticketing reste bancale. Il faut ensuite aligner l’outil avec la réalité du terrain, pas avec un modèle trop ambitieux.
- Définir les familles de demandes : incident, demande de service, accès, matériel, téléphonie, onboarding.
- Créer des catégories lisibles : par symptôme ou par service, mais pas les deux en même temps au départ.
- Segmenter les groupes de traitement : support N1, support poste de travail, applications métiers, prestataire.
- Définir les profils : demandeur, technicien, superviseur, administrateur.
- Standardiser les champs obligatoires : site, impact, service concerné, description du besoin.
Cette étape peut paraître basique. Elle produit pourtant un gain très concret. Dans une petite équipe, économiser seulement 2 à 3 minutes de tri par ticket représente plusieurs heures récupérées chaque semaine. Ce temps est ensuite réinvesti dans la résolution, la documentation et le suivi qualité. C’est là que le ROI devient visible, bien avant les fonctions les plus avancées.
À retenir : une mauvaise structure initiale transforme GLPI en boîte de réception améliorée. Une bonne structure en fait un véritable outil de pilotage du support.
Pour aller plus loin sur l’organisation d’un flux de demandes sans complexifier le dispositif, ce guide sur la structuration simple du ticketing GLPI illustre bien la logique à adopter dans une PME.
Autre point souvent sous-estimé : la collecte des demandes. Si les utilisateurs continuent d’écrire à une boîte mail générique, GLPI doit transformer ces messages en tickets propres. Le collecteur d’e-mails est ici décisif. La documentation sur la conversion des e-mails en tickets aide à fiabiliser cette brique essentielle. Sans cela, le flux entrant reste partiellement manuel, donc plus lent et moins traçable.
| Élément de configuration | Erreur fréquente | Effet sur le support | Bonne pratique |
|---|---|---|---|
| Catégories | Trop nombreuses dès le départ | Confusion au dépôt | Commencer avec 8 à 12 catégories maximum |
| Groupes | Un seul groupe pour tout | File d’attente saturée | Créer des groupes par domaine de traitement |
| Profils | Droits trop larges | Risque d’erreurs | Limiter les permissions par rôle |
| Canaux entrants | E-mail non structuré | Tickets incomplets | Utiliser portail + collecteur correctement paramétré |
Les entreprises qui réussissent leur démarrage avec GLPI ticketing ont un point commun : elles résistent à l’envie de tout modéliser d’un coup. Elles construisent un socle stable, puis affinent. C’est cette discipline qui prépare le terrain pour la suite : la priorisation, les SLA et les automatisations utiles.
Découvrez comment AirAgent gère ça
Gestion des tickets GLPI : construire un workflow clair pour le support informatique
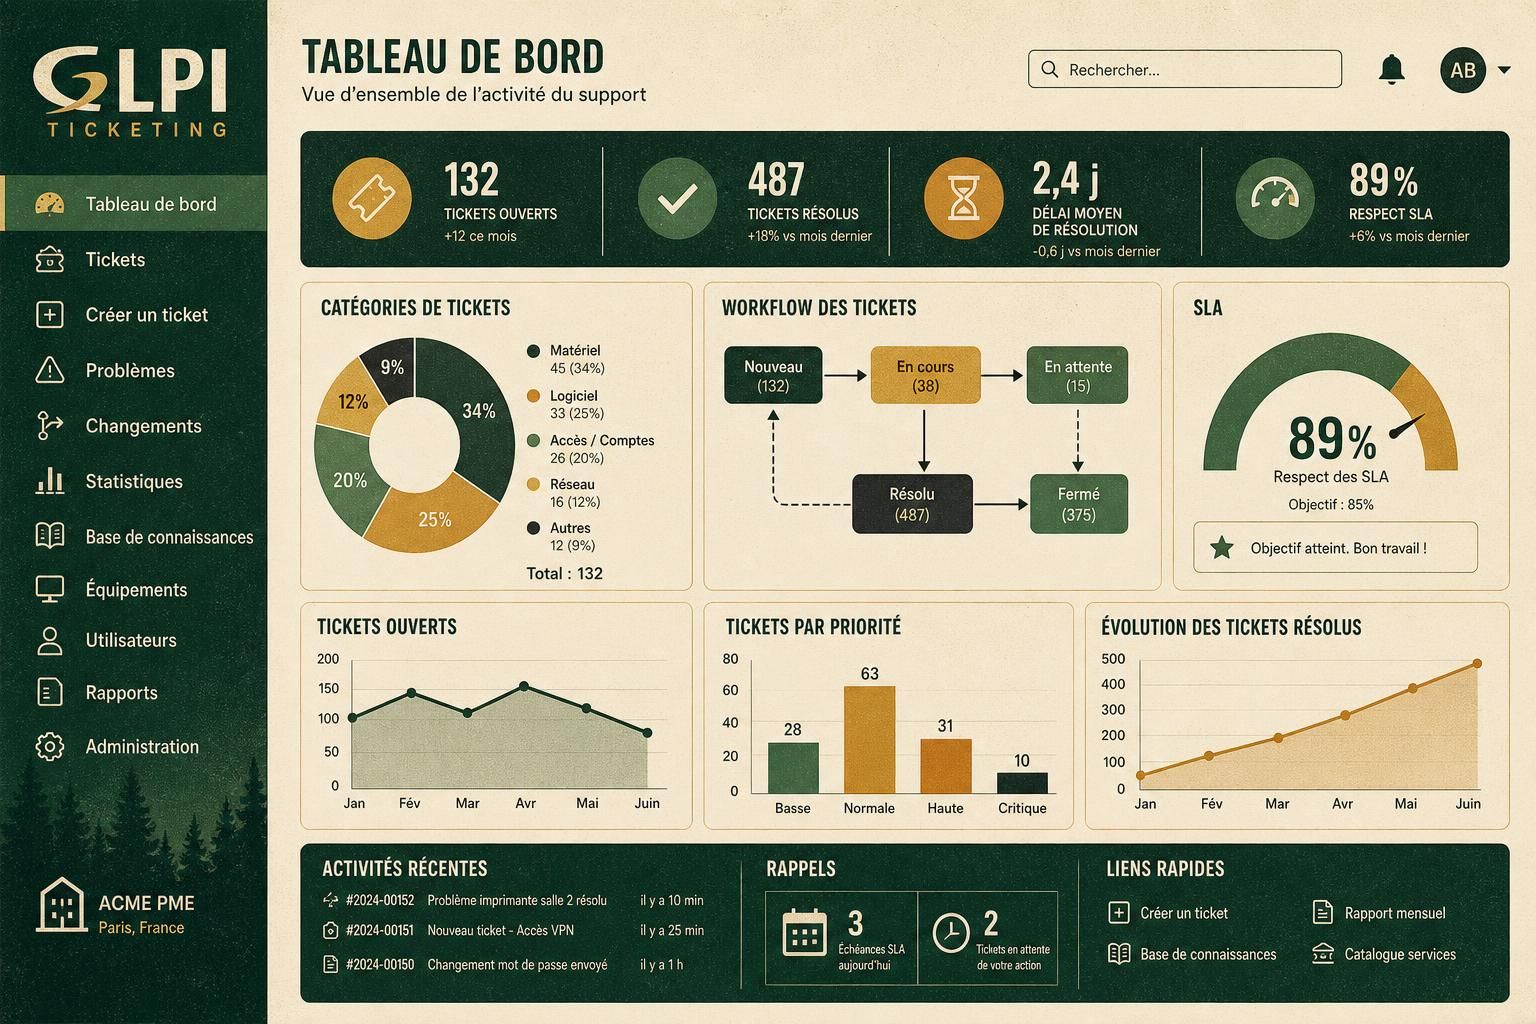
Une fois la base posée, le vrai sujet devient le workflow. Dans GLPI, la circulation d’un ticket doit être lisible du début à la fin. Sinon, les équipes compensent par des habitudes orales, des relances manuelles et des tableaux parallèles. Le logiciel existe justement pour éviter cela. Un flux clair réduit les oublis, accélère les prises en charge et donne à la direction une vision exploitable du service rendu.
Le cycle le plus robuste dans une PME reste généralement simple : création, qualification, affectation, traitement, attente éventuelle, résolution, clôture. L’erreur classique consiste à multiplier les statuts intermédiaires. On croit gagner en finesse, mais on augmente surtout la friction. Quand un agent hésite entre trois états proches, il perd du temps et dégrade la fiabilité du reporting. Un bon processus n’a pas besoin d’être sophistiqué pour être efficace.
Il faut surtout distinguer deux réalités métier : l’incident et la demande de service. L’incident bloque ou dégrade une activité existante. La demande concerne un besoin nouveau ou planifié, comme un accès, un changement de matériel ou une installation logicielle. Mélanger les deux dans les mêmes files de traitement brouille les délais attendus. Les utilisateurs ont alors le sentiment que tout est “urgent”, ce qui finit par vider la notion d’urgence de son sens.
Quand chaque ticket semble prioritaire, plus rien ne l’est vraiment. Le pilotage du support repose d’abord sur des règles compréhensibles par tous.
La logique de priorisation doit ensuite être définie noir sur blanc. Dans l’esprit ITIL, repris par le module d’assistance de GLPI, la priorité découle souvent de l’impact et de l’urgence. Cette approche reste très pertinente pour les PME, à condition de rester pragmatique. Une panne qui bloque l’ensemble de la comptabilité un jour de clôture n’a évidemment pas le même poids qu’un problème de confort sur un poste isolé.
- Qualifier la nature de la demande.
- Mesurer l’impact métier réel.
- Évaluer l’urgence temporelle.
- Affecter le bon groupe ou le bon technicien.
- Suivre l’avancement sans ressaisie parallèle.
- Clôturer avec une information utile pour l’historique.
Pour les responsables qui veulent cadrer cette étape, la documentation sur la gestion des tickets dans GLPI détaille bien les principes de statuts, de priorité et de traitement. De son côté, ce guide sur le ticketing informatique structuré apporte une lecture plus orientée organisation et performance opérationnelle.
Conseil : commencez avec une matrice de priorité à 4 niveaux maximum. Au-delà, la différence entre deux niveaux voisins devient difficile à appliquer de façon homogène.
Dans les entreprises les plus efficaces, la qualification initiale n’est pas laissée au hasard. Un formulaire demande les bonnes informations. Les catégories limitent les ambiguïtés. L’affectation se fait selon des règles claires. Et surtout, les exceptions restent rares. C’est ce point qui fait gagner du temps. Si 80 % des tickets suivent une route prévisible, l’équipe conserve de l’énergie pour les cas réellement complexes.
Le support informatique a aussi besoin de visibilité. Un superviseur doit pouvoir voir en quelques secondes le volume entrant, les tickets en retard, les demandes en attente utilisateur et les points de blocage. C’est ici qu’un flux bien conçu change la donne. Il ne sert pas seulement à traiter le quotidien ; il donne une matière exploitable pour ajuster l’équipe, revoir une procédure ou décider d’un investissement matériel.
Pour les PME qui veulent compléter leur dispositif par une réponse automatisée en amont, cette solution de support client permet de filtrer et orienter les demandes avant qu’elles n’arrivent dans les files saturées.
Un workflow bien pensé a donc une double utilité : il réduit la charge invisible et améliore la qualité perçue. C’est cette combinaison qui prépare logiquement le terrain des SLA et des notifications.
Configuration des SLA et des notifications dans GLPI : ce qui améliore vraiment les délais
Dans beaucoup de projets, les SLA sont traités comme un simple paramètre. En réalité, ils constituent un contrat opérationnel entre le support et l’entreprise. Mal définis, ils créent de la frustration et de faux retards. Bien configurés, ils clarifient les engagements, hiérarchisent les efforts et rendent les arbitrages beaucoup plus simples. Le piège le plus fréquent consiste à promettre des délais uniformes alors que les typologies de demandes n’ont rien de comparable.
Une PME n’a pas besoin d’un catalogue de services tentaculaire pour être performante. Elle a besoin de quelques engagements réalistes, suivis et compris. Par exemple, un incident bloquant sur un outil commercial peut exiger une prise en charge sous 30 minutes, alors qu’une demande d’installation logicielle peut raisonnablement être traitée sous 24 à 48 heures. Ce réalisme protège à la fois les utilisateurs et l’équipe support.
- SLA de prise en compte : délai avant premier traitement.
- SLA de résolution : délai cible avant solution ou contournement.
- Règles d’escalade : alerte avant dépassement.
- Exceptions planifiées : maintenance, dépendance fournisseur, attente utilisateur.
Les notifications jouent un rôle tout aussi stratégique. Mal réglées, elles saturent les boîtes mail et produisent un effet inverse à celui recherché. Quand tout le monde reçoit tout, plus personne ne lit rien. Une bonne configuration distingue les événements utiles selon le rôle. Le demandeur doit être informé aux moments clés. Le technicien doit recevoir des alertes exploitables. Le manager doit voir les dépassements, pas chaque commentaire ajouté au ticket.
Attention : le volume d’e-mails automatiques est un indicateur de qualité. Si les agents créent des filtres pour survivre aux alertes, la configuration des notifications est déjà trop bruyante.
Un paramétrage efficace repose souvent sur quelques règles sobres :
- Notifier le demandeur à la création, à la prise en charge, à la résolution et à la clôture.
- Notifier le groupe assigné uniquement sur les nouveaux tickets et les réaffectations.
- Déclencher une alerte de supervision avant l’échéance SLA, pas uniquement après dépassement.
- Éviter les doublons entre commentaires publics, suivis internes et changements d’état.
Dans un service de 4 à 6 agents, ce simple réglage peut faire gagner plusieurs dizaines de minutes par jour. Ce chiffre paraît modeste. Sur un mois, il devient significatif. Surtout, il réduit la fatigue décisionnelle des équipes. Or un support performant ne dépend pas seulement des compétences techniques ; il dépend aussi de l’attention disponible.
Pour un cadrage plus opérationnel, des ressources comme ce wiki consacré au ticketing GLPI ou ce tutoriel de configuration GLPI permettent de visualiser l’enchaînement des réglages utiles dans un contexte concret.
| Type de ticket | Exemple | SLA conseillé | Notification utile |
|---|---|---|---|
| Incident critique | ERP indisponible | 30 min prise en compte / 4 h résolution | Alerte immédiate groupe + superviseur |
| Incident standard | Imprimante locale HS | 4 h / 24 h | Affectation + rappel avant échéance |
| Demande d’accès | Création compte applicatif | 8 h / 48 h | Validation + résolution |
| Demande matériel | Casque ou écran | 24 h / 5 jours | Confirmation + suivi de livraison |
Un bon système de SLA ne sert pas à “mettre la pression” au support. Il sert à arbitrer intelligemment. C’est aussi une protection managériale. Quand les engagements sont publics et cohérents, les débats deviennent plus objectifs. Cette mécanique ne prend toute sa valeur que si elle s’appuie, ensuite, sur des habitudes d’exploitation rigoureuses.
AirAgent fait exactement ça — et à partir de 49€/mois : voyez comment AirAgent automatise ce processus.
Bonnes pratiques GLPI au quotidien : éviter les dérives qui sabotent la gestion des tickets
La meilleure configuration du monde ne tient pas longtemps sans discipline d’usage. C’est souvent à ce stade que les projets décrochent. Les premiers mois se passent bien, puis les habitudes reviennent : tickets sans description, résolutions non documentées, statuts oubliés, affectations improvisées. Le problème n’est plus l’outil. C’est la gouvernance opérationnelle. Et cette gouvernance ne demande pas forcément plus de moyens ; elle demande des règles simples, répétées et suivies.
Dans une PME industrielle, par exemple, le support a constaté que plus de 35 % des tickets étaient créés avec des informations insuffisantes. La résolution était pourtant possible, mais le temps de qualification explosait. La solution n’a pas été de faire une grande refonte. L’équipe a ajouté trois champs obligatoires, limité les catégories visibles selon le profil et diffusé une trame de description très courte. En un trimestre, le temps moyen avant affectation a nettement baissé.
Un ticket bien rédigé est déjà un ticket à moitié traité. La qualité d’entrée conditionne la vitesse de sortie.
Les bonnes pratiques les plus rentables sont souvent les moins spectaculaires. Elles touchent à l’hygiène quotidienne du système, pas à la sophistication. Voici celles qui produisent le plus d’impact dans une petite ou moyenne structure :
- Limiter les catégories redondantes pour éviter les mauvais dépôts.
- Documenter les résolutions fréquentes afin de capitaliser.
- Clôturer proprement les tickets terminés pour garder des reportings fiables.
- Réviser chaque mois les tickets en attente trop anciens.
- Mesurer les réouvertures, excellent signal d’une résolution fragile.
- Contrôler les tickets sans assignation au moins une fois par jour.
Un autre point clé concerne les escalades. Beaucoup d’équipes escaladent trop tôt ou trop tard. Trop tôt, elles engorgent les profils experts. Trop tard, elles détériorent la satisfaction interne. La meilleure approche consiste à définir des seuils simples : dépassement d’un temps de diagnostic, dépendance fournisseur, incident récurrent, impact multi-utilisateurs, ou risque métier élevé. L’escalade cesse alors d’être émotionnelle ; elle devient pilotée.
Il faut également penser à la formation. Même un outil connu comme GLPI mérite une montée en compétence minimale. Les équipes qui investissent quelques heures dans des cas pratiques récupèrent ensuite ce temps au centuple. Les ressources de terrain sont nombreuses, qu’il s’agisse de formations officielles GLPI, de retours d’expérience comme cette mise en œuvre concrète du ticketing GLPI ou de supports pédagogiques tels que ce TP GLPI détaillé.
Bon à savoir : la maturité d’un service de support se voit rarement dans le nombre de fonctionnalités activées. Elle se voit dans la régularité des pratiques et la qualité des données produites.
Pour certaines PME, le point de rupture ne vient pas du volume mais des interruptions permanentes. Appels, relances, demandes mal aiguillées, escalades verbales : tout cela contourne GLPI et affaiblit la chaîne de traitement. Réduire ces interruptions est un objectif en soi. C’est précisément pourquoi certaines entreprises ajoutent une couche de qualification ou d’accueil automatisé avant l’ouverture du ticket.
Si vous voulez comparer votre organisation actuelle avec un traitement plus fluide des demandes entrantes, comparez avec votre solution actuelle. La différence se joue souvent sur les premières minutes du parcours utilisateur.
Quand les habitudes sont stabilisées, GLPI cesse d’être un simple registre d’incidents. Il devient un outil de méthode, capable de soutenir durablement la performance du support informatique.
GLPI ticketing pour PME : piloter la performance, former les équipes et faire évoluer la configuration
Le dernier niveau de maturité consiste à piloter, pas seulement à exploiter. Une PME n’a pas besoin d’un centre de reporting complexe pour progresser. Elle a besoin de quelques indicateurs suivis avec constance. Le volume entrant hebdomadaire, le délai moyen avant prise en charge, le respect des SLA, le taux de tickets réouverts et la part des demandes récurrentes suffisent souvent à révéler les vrais irritants. Ces données orientent les décisions bien mieux que les impressions.
Imaginons une société de services de 120 personnes. Son responsable support constate une hausse des délais et pense manquer d’effectif. L’analyse GLPI montre en réalité autre chose : une explosion des demandes d’accès, concentrées les lundis, liée à un processus RH incomplet sur les arrivées collaborateurs. Sans ce regard, l’entreprise aurait probablement recruté ou sous-traité à tort. Avec ce regard, elle corrige le processus amont et réduit immédiatement la charge du helpdesk. Voilà le type de gains que permet un ticketing bien utilisé.
Les tableaux de bord doivent rester lisibles pour un dirigeant non technicien. L’objectif n’est pas de démontrer la complexité du support. L’objectif est de montrer où se trouvent les pertes de temps, les risques métier et les opportunités d’amélioration. Une lecture simple, partagée une fois par mois, crée déjà une culture de pilotage très supérieure à celle de nombreuses petites structures.
- Tickets créés : mesure de la charge.
- Délai de première réponse : perception immédiate du service.
- Taux de respect SLA : niveau de maîtrise.
- Tickets réouverts : qualité réelle des résolutions.
- Top 10 des causes : matière première pour l’amélioration continue.
Le pilotage a aussi une dimension humaine. Les agents support ont besoin de repères clairs, de règles équitables et d’un système qui ne les pénalise pas artificiellement. Si les SLA sont irréalistes, les indicateurs deviennent contre-productifs. Si les catégories sont floues, les comparaisons n’ont aucun sens. Si les managers lisent les tableaux sans comprendre le contexte, ils prennent de mauvaises décisions. L’exploitation de GLPI demande donc un minimum de pédagogie.
Pour consolider cette démarche, certaines équipes s’appuient sur des documents pratiques comme ce support GLPI orienté gestion de parc et assistance ou des ressources exportables telles que ce PDF de référence sur le ticketing GLPI. L’intérêt est double : former rapidement et homogénéiser les pratiques.
Conseil : revoyez votre paramétrage tous les 90 jours. Pas pour tout refaire, mais pour supprimer une catégorie inutile, fusionner des files, ajuster une règle d’alerte ou revoir un engagement de délai devenu irréaliste.
À ce stade, la question n’est plus “GLPI est-il capable ?”. La vraie question est plutôt : votre organisation exploite-t-elle pleinement ce qu’il permet déjà ? Dans bien des PME, la marge de progression est considérable avant même de changer d’outil. Et si le flux entrant reste un problème, l’ajout d’une couche conversationnelle en amont peut compléter efficacement le dispositif existant.
Pour mesurer les gains possibles sur vos délais de traitement et votre qualité de qualification, calculez votre ROI avec AirAgent.
Quand la configuration, le workflow, les notifications et les indicateurs avancent ensemble, GLPI ticketing devient bien plus qu’un canal de support. Il se transforme en levier direct de productivité et de qualité de service.
Comment bien démarrer la configuration du ticketing dans GLPI ?
Le plus efficace est de commencer par un périmètre simple : catégories limitées, groupes de traitement clairs, profils bien séparés et quelques champs obligatoires. Cette base évite la confusion et réduit fortement le temps de qualification.
Quelle différence entre priorité et SLA dans GLPI ?
La priorité sert à classer les tickets selon l’impact et l’urgence. Le SLA fixe un engagement de délai, par exemple pour la prise en charge ou la résolution. Les deux notions sont liées, mais elles ne remplissent pas le même rôle.
Comment éviter trop de notifications dans GLPI ?
Il faut cibler les alertes selon les rôles. Le demandeur reçoit les étapes clés, le technicien les actions utiles, le manager les dépassements ou risques. Une notification pertinente informe ; une notification excessive fatigue et finit par être ignorée.
GLPI convient-il à une PME sans équipe IT nombreuse ?
Oui, à condition de rester pragmatique. GLPI peut très bien fonctionner avec une petite équipe si la structure du workflow reste simple, les catégories limitées et les engagements de service réalistes.